Pipelines de données
Open sourceAI Web Scraping Pipeline
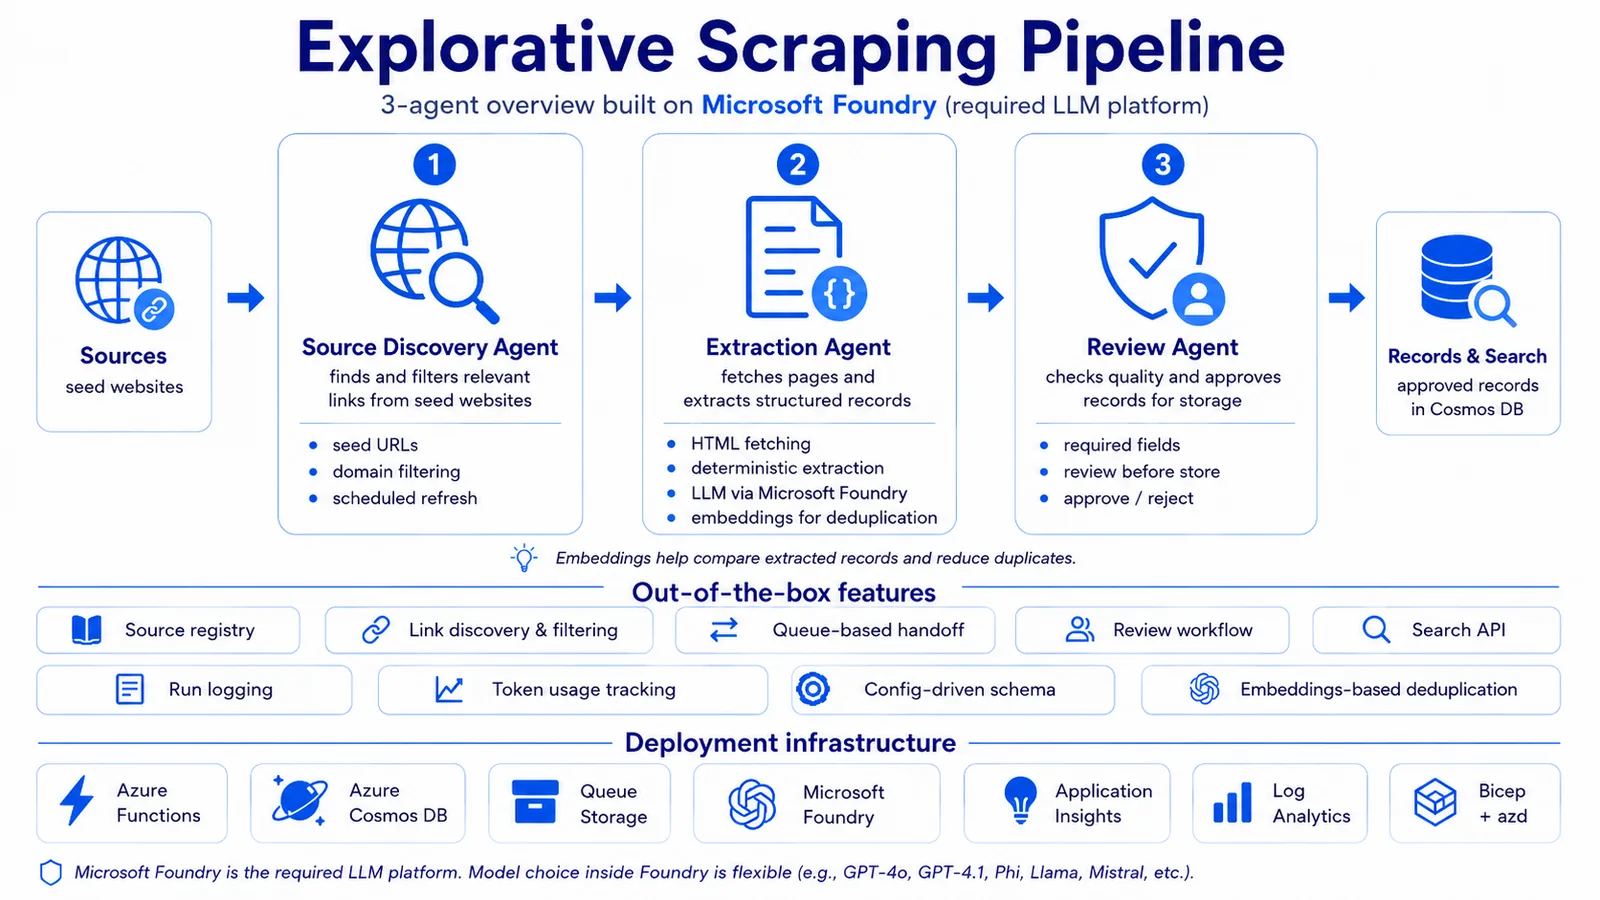
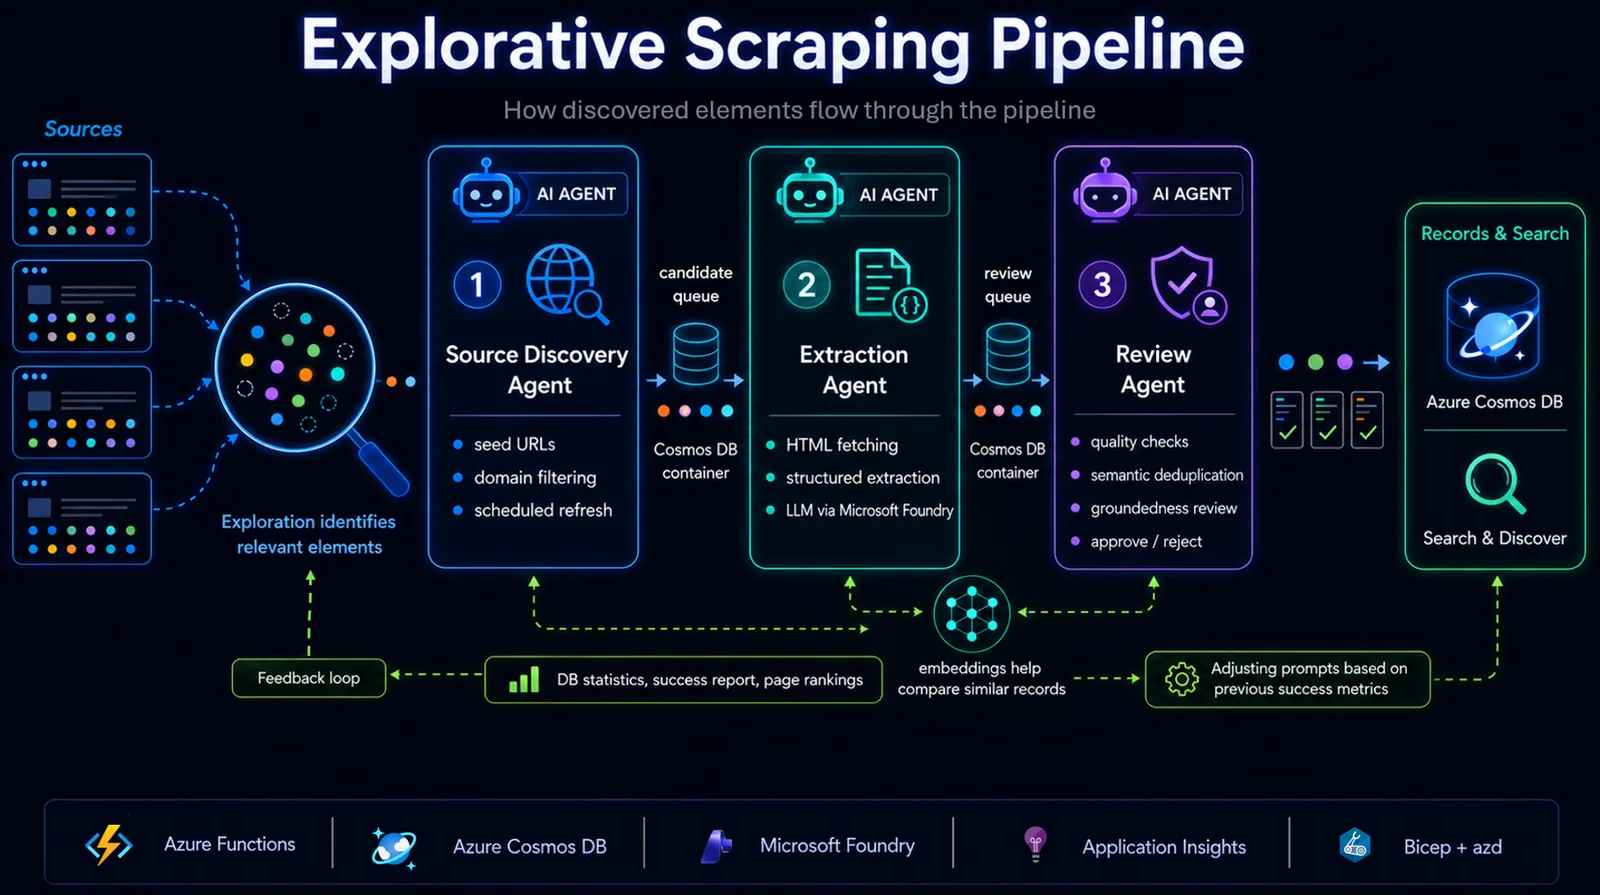
Ce pipeline est le moteur d’AIUseCaseHub, publié comme projet open source configurable. Trois agents logiques tournent dans une même application Azure Functions : la découverte trouve les pages candidates, l’extraction les transforme en fiches structurées, et la revue valide les champs, détecte les doublons grâce aux embeddings et évalue l’ancrage dans la source avant tout enregistrement. En changeant le schéma, les sources et les prompts, on l’adapte à d’autres domaines de recherche, comme les témoignages clients, les projets de construction ou la modernisation du secteur public.
- Mon rôle
- Créateur, architecte et développeur
- Début
- Mise à jour
- Visibilité
- Open source
- agents : découverte, extraction, revue
- 3
- fiches qui alimentent AIUseCaseHub
- ~4 000
- déploiement Azure avec azd et Bicep
- 1 clic
Problème
Le scraping avec des LLM est facile à lancer et difficile à fiabiliser. Sans déduplication, contrôle d’ancrage et étapes de revue, on se retrouve avec un gros jeu de données auquel personne ne peut se fier.
Solution
Un pipeline pensé pour la production, avec sources et schéma configurables, maîtrise prudente des coûts, score d’ancrage avec nouvelle tentative et étape de revue explicite avant l’enregistrement des fiches.
Architecture
Les agents de découverte, d’extraction et de revue se transmettent le travail via des conteneurs Cosmos DB qui servent de files d’attente. Les fiches validées arrivent dans un conteneur Records avec recherche vectorielle pour détecter les doublons. Le tout se déploie avec azd et Bicep sur un plan Flex Consumption.
Ce que j’en retiens
Les contrôles qualité sont le produit. L’appel au modèle est la partie facile ; la déduplication, l’ancrage et le suivi du coût en tokens déterminent si les données valent quelque chose.
Technologies
- Python
- Azure Functions
- Cosmos DB
- Microsoft Foundry
- Microsoft Agent Framework
- Bicep and azd
#agents #web-scraping #groundedness #open-source
Plus de captures d’écran