Evaluation
Open SourceSwiss German Voice Benchmark
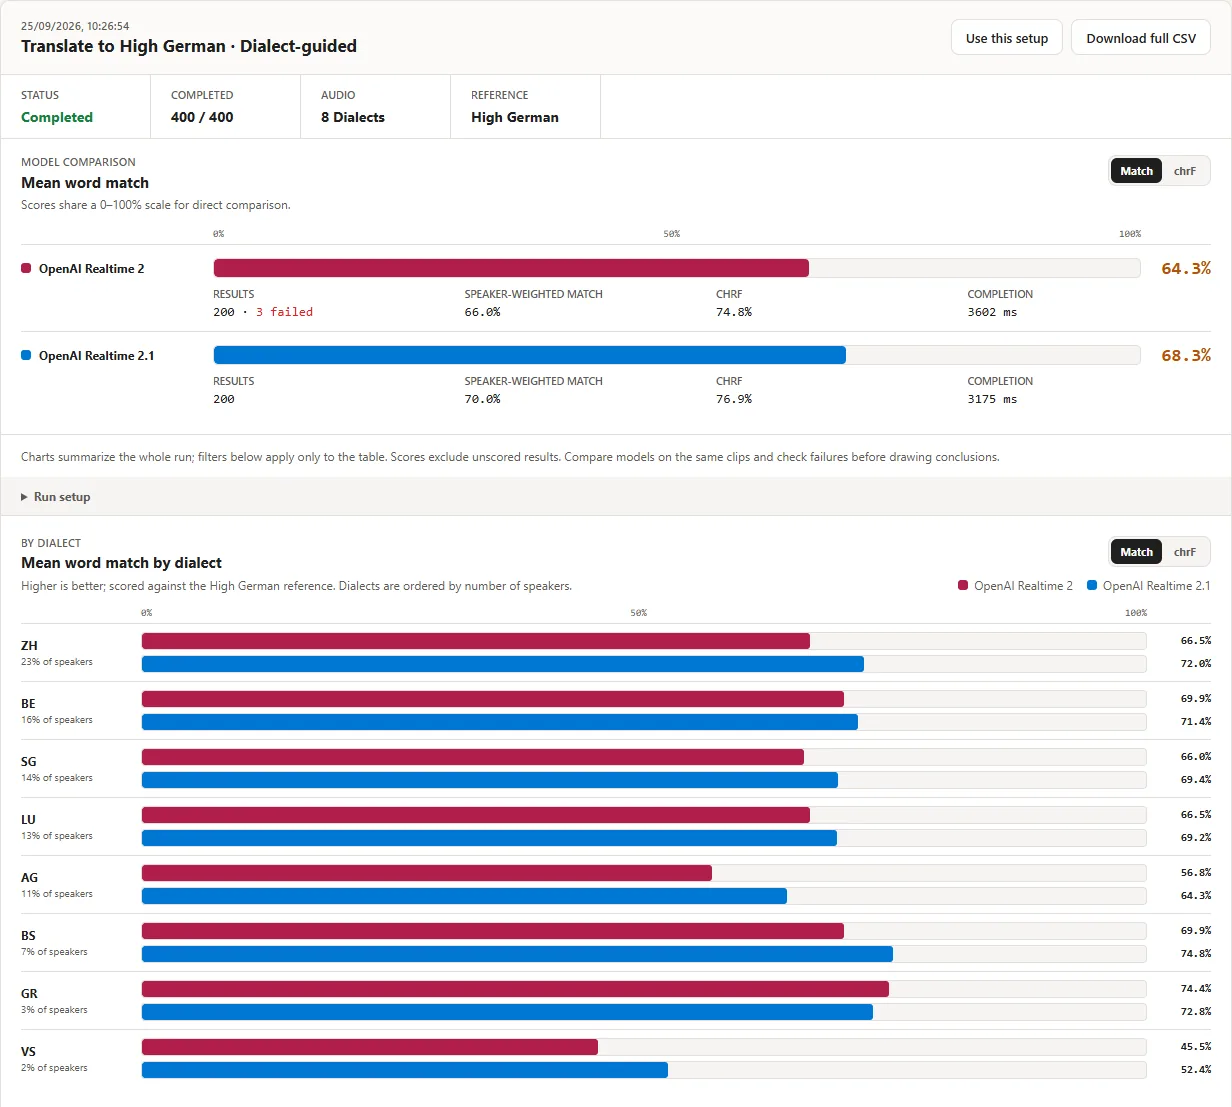
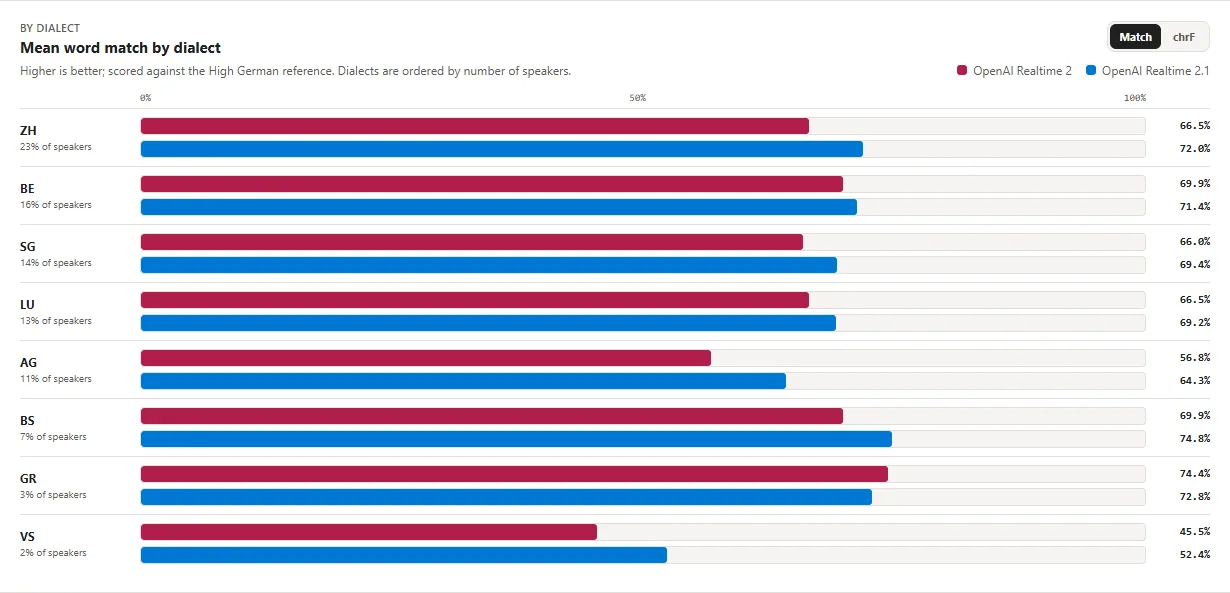
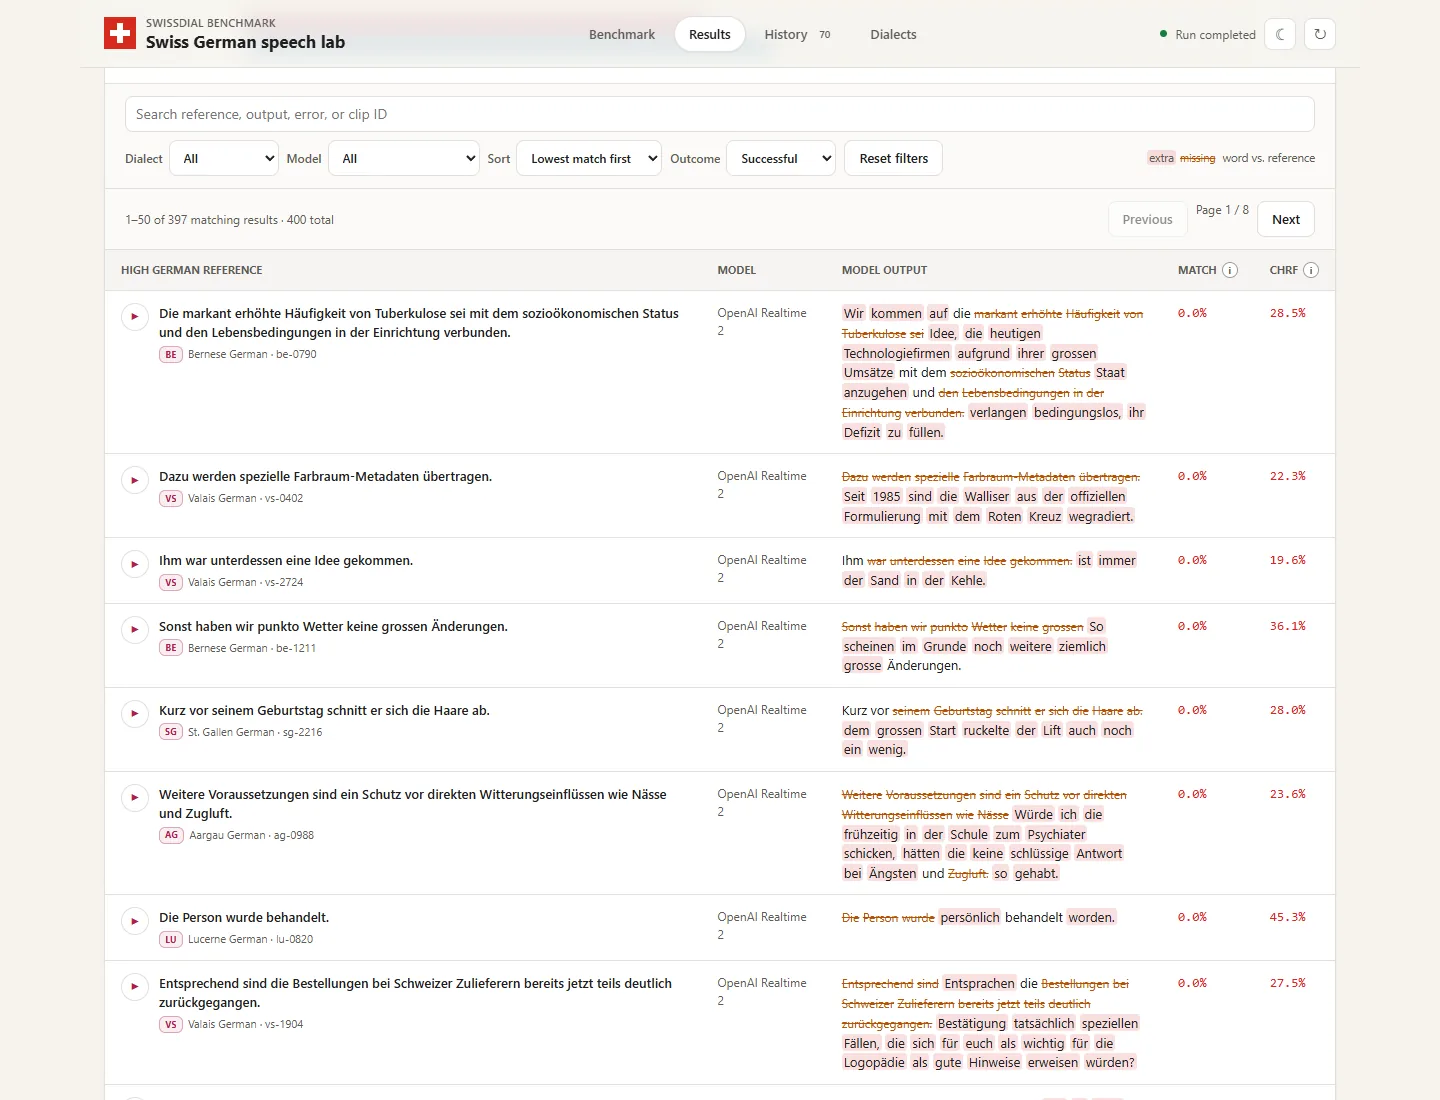
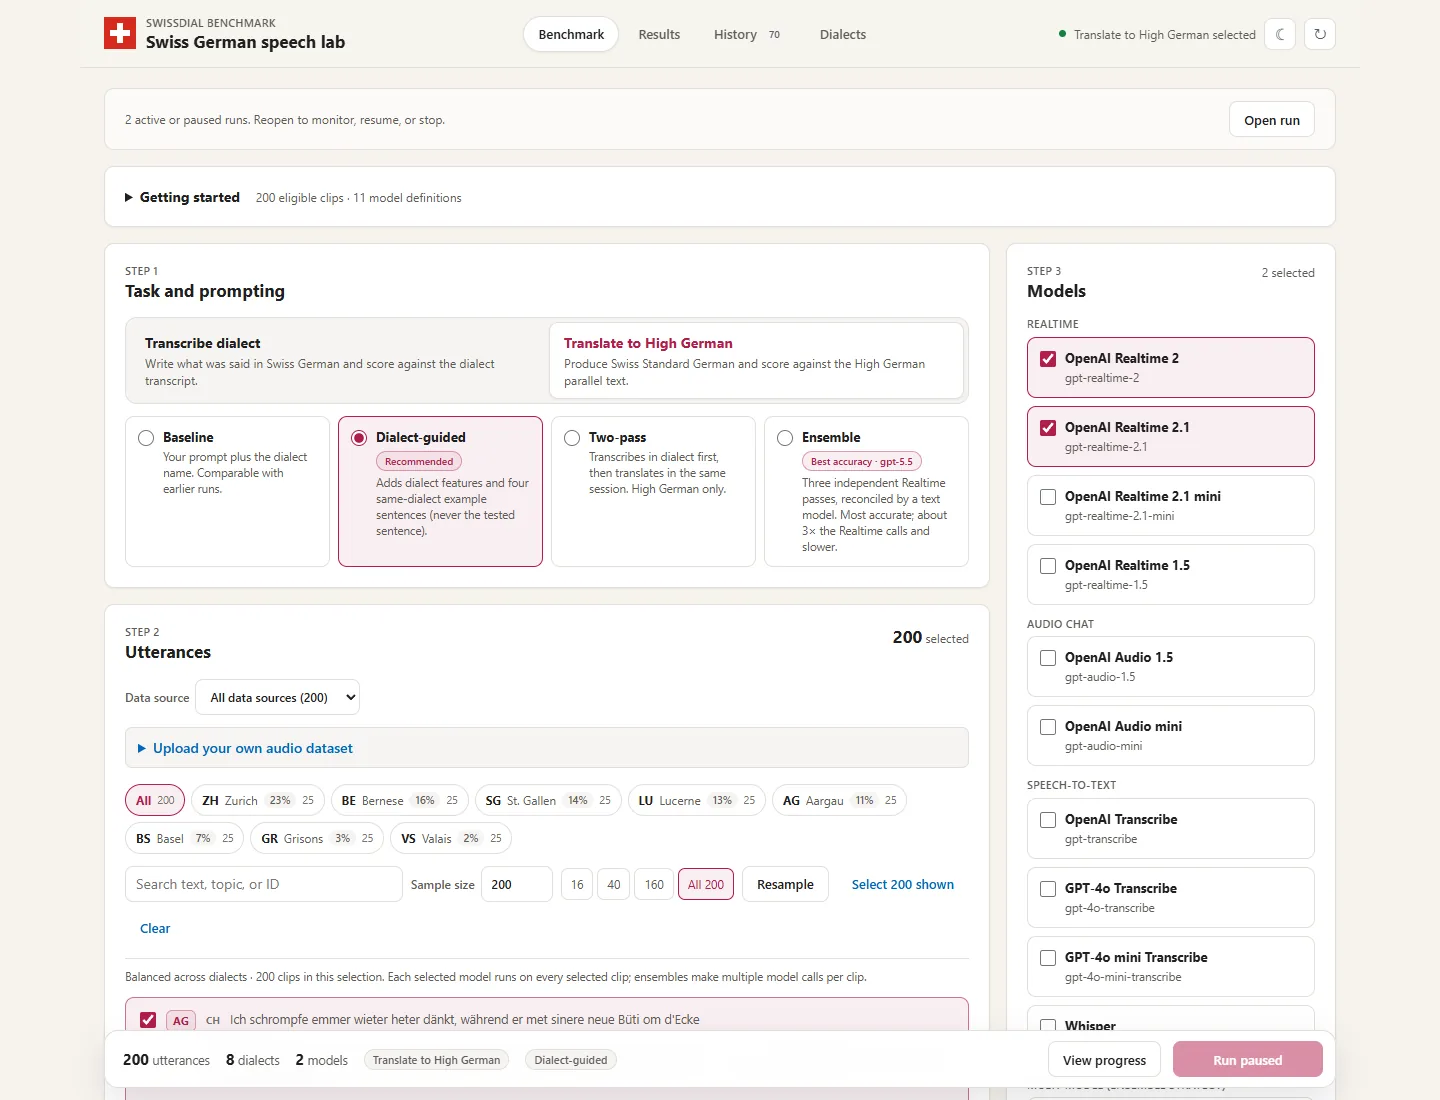
Dieser Benchmark wählt Aufnahmen aus ETH SwissDial in acht Schweizer Dialekten aus, lässt sprachfähige Modelle zwei Aufgaben lösen (wortgetreue Transkription im Dialekt und Übersetzung ins Hochdeutsche) und zeigt jedes Transkript mit Unterschieden auf Wortebene. Er unterstützt verschiedene Prompting-Strategien, Ensembles, nach Sprecherzahl der Dialekte gewichtete Scores und Exporte jedes gespeicherten Laufs.
- Meine Rolle
- Gründer und Entwickler
- Gestartet
- Aktualisiert
- Sichtbarkeit
- Open Source
- SwissDial-Clips, 25 pro Dialekt
- 200
- Schweizer Dialekte im Vergleich
- 8
- beste gepaarte Wortübereinstimmung (Realtime 2.1, Hochdeutsch)
- 68,6 %
Problem
Sprachmodelle werden meist auf Standardsprachen evaluiert. Für Schweizerdeutsch haben Teams kaum Belege, welches Modell und welche Prompting-Strategie pro Dialekt tatsächlich funktioniert.
Lösung
Ein reproduzierbarer Benchmark mit ausgewogenen Dialekt-Stichproben, mehreren Aufgaben und Strategien, gepaarten Vergleichen und einer Oberfläche, in der man einzelne Fehler prüfen kann, statt einer einzigen Kennzahl zu vertrauen.
Architektur
Eine lokale API und ein Dashboard steuern Modellläufe über eine Auswahl von SwissDial-Clips, streamen die Ergebnisse, speichern jedes Transkript und jede Zeitmessung in einer lokalen Datenbank und berechnen gepaarte Kennzahlen, sodass Modelle nur auf Clips verglichen werden, die beide erfolgreich verarbeitet haben.
Was ich gelernt habe
Einzelne Kennzahlen verbergen viel. Auswertungen pro Dialekt, gepaarte Vergleiche und die Möglichkeit, einzelne Fehler zu lesen, haben meine Schlüsse stärker verändert als jeder Gesamtwert.
Technologien
- Python
- Microsoft Foundry
- OpenAI Realtime
- SwissDial
- WER / CER / chrF
- React
#speech-ai #evaluation #swiss-german #benchmarks
Weitere Screenshots