Évaluation
Open sourceSWE-RL Forge Lite
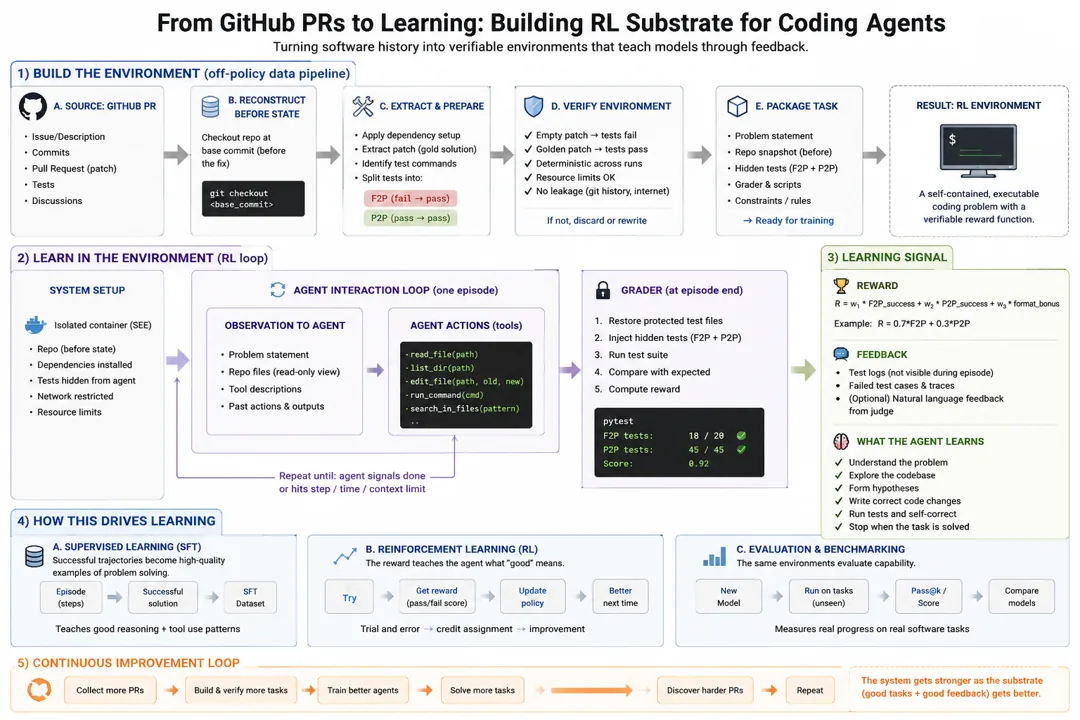
SWE-RL Forge Lite convertit une pull request GitHub fusionnée en tâche autonome et exécutable. Il reconstitue le dépôt avant la correction, vérifie que le patch historique s’applique toujours, exécute les tests avant et après dans Docker, répète l’exécution après le patch pour détecter le non-déterminisme, puis empaquette le tout avec un prompt, un patch de référence, un Dockerfile, un script de récompense et un verdict de qualité.
- Mon rôle
- Créateur et développeur
- Début
- Mise à jour
- Visibilité
- Open source
- tests isolés avant et après
- Docker
- récompense fondée sur les tests, par tâche
- Binaire
- verdicts : utilisable, à revoir, invalide
- 3
Problème
Les benchmarks d’agents de code reposent souvent sur des bugs synthétiques ou sur des tâches impossibles à vérifier de façon fiable, ce qui rend les récompenses bruitées.
Solution
Un pipeline local qui ne qualifie une tâche d’utilisable que si elle est reproductible, déterministe et vérifiable par les tests, pour que la réussite repose sur des preuves exécutables.
Architecture
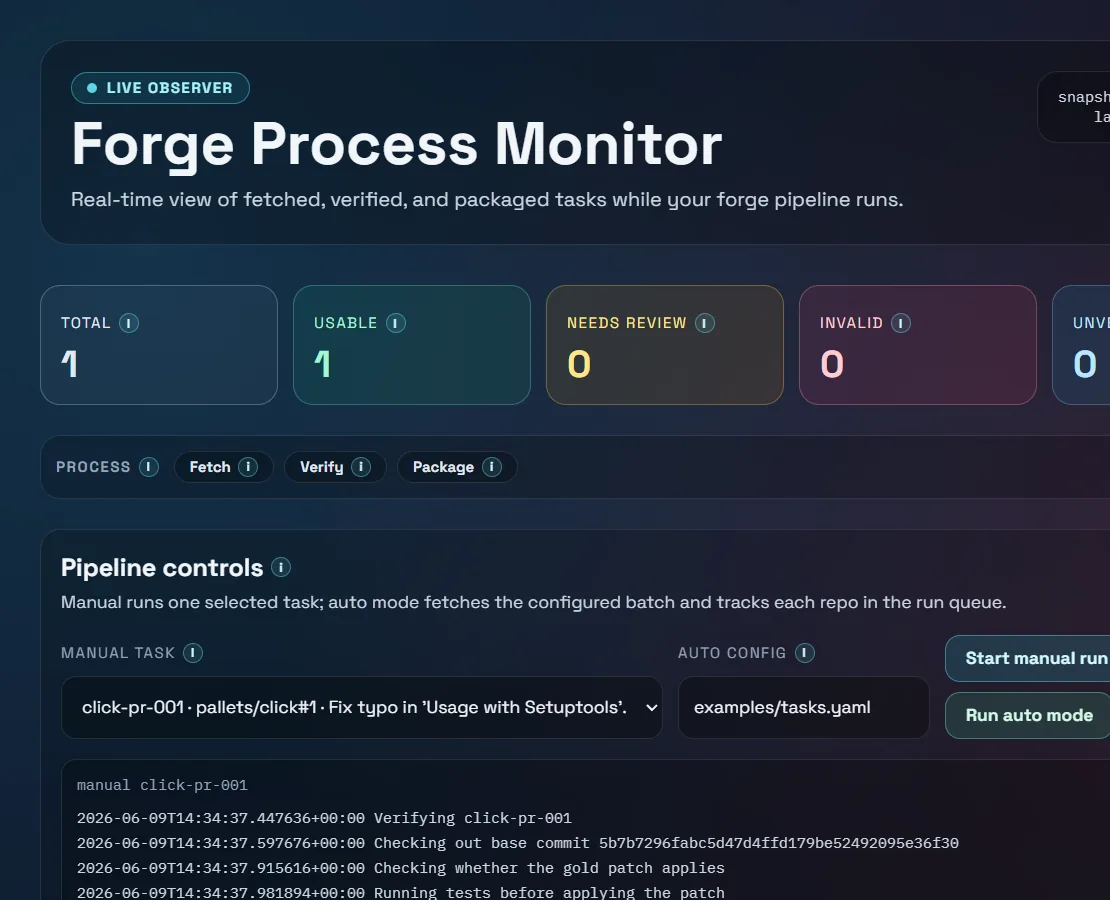
Une suite d’étapes CLI combinables (explore, fetch, verify, package, reward) écrit sur disque des artefacts inspectables. Un tableau de bord en direct observe le pipeline et affiche les contrôles qualité et l’inventaire des paquets d’entraînement.
Ce que j’en retiens
La plupart des pull requests historiques ne font pas de bonnes tâches d’entraînement. Un contrôle qualité strict, qui classe les tâches en utilisables, à revoir ou invalides, est ce qui garde un jeu de données fiable.
Technologies
- Python
- Docker
- GitHub API
- Executable rewards
- React dashboard
#coding-agents #reinforcement-learning #evaluation #benchmarks
Plus de captures d’écran