Evaluation
Open SourceSWE-RL Forge Lite
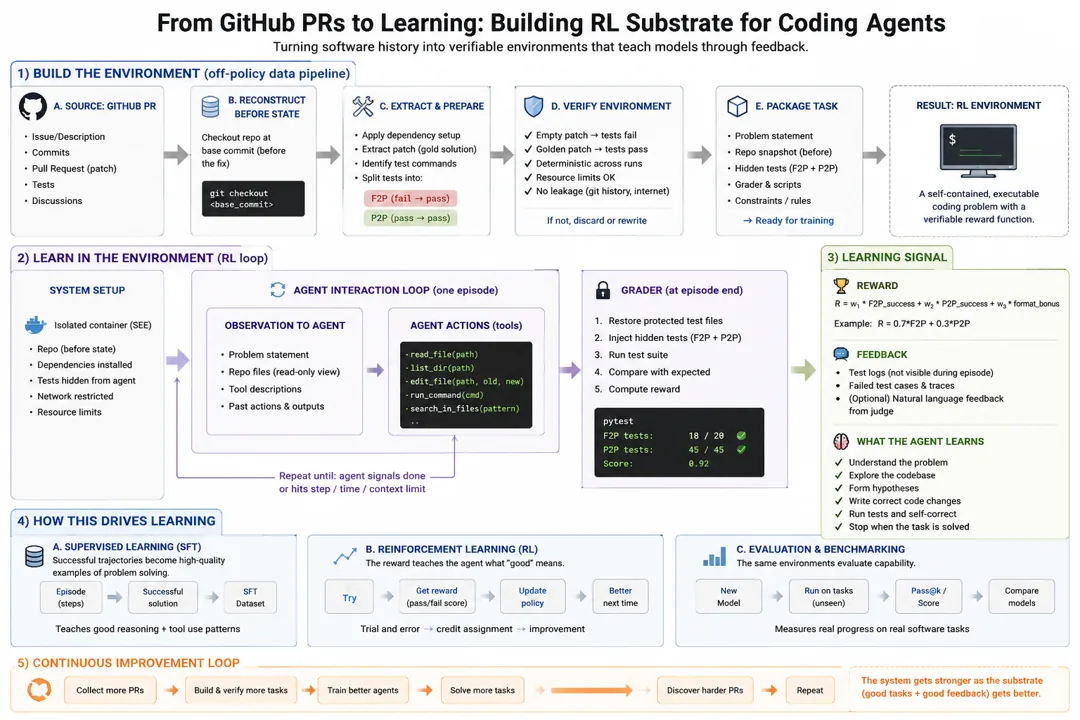
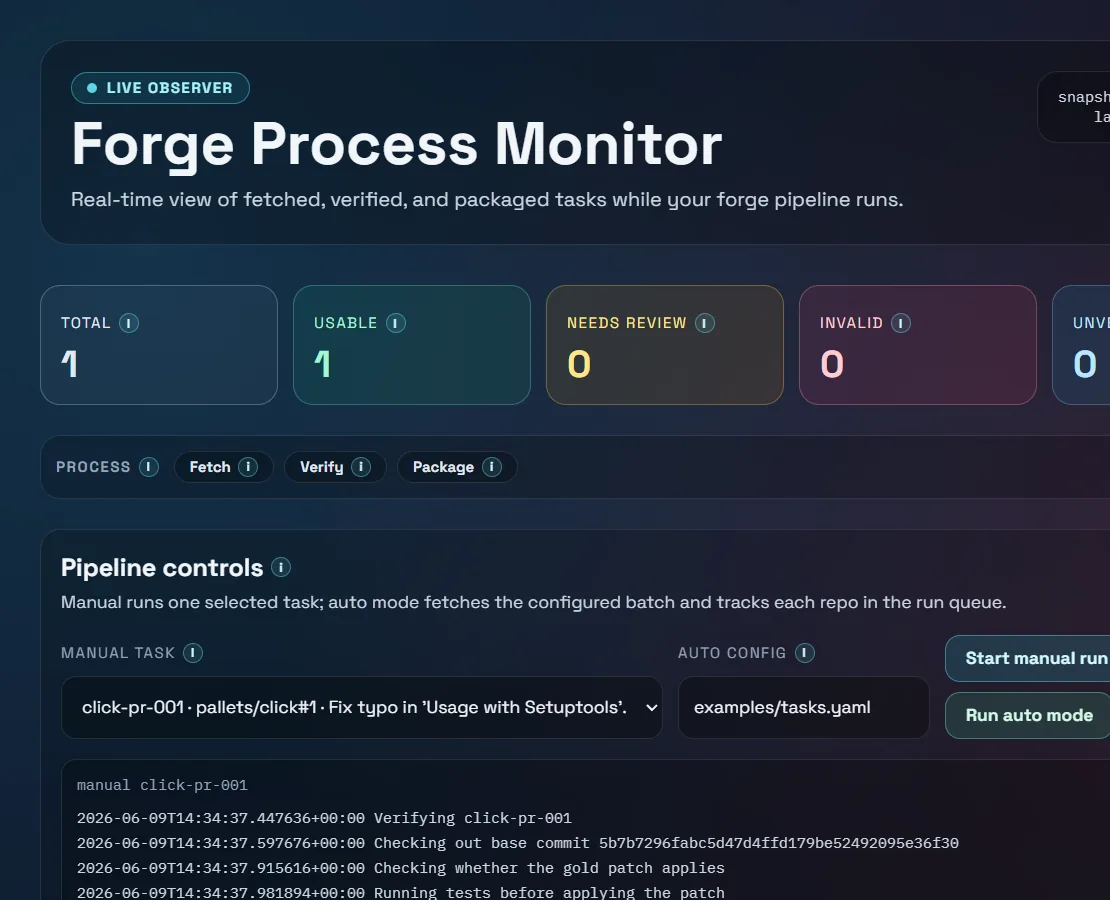
SWE-RL Forge Lite wandelt einen gemergten GitHub-Pull-Request in eine eigenständige, ausführbare Aufgabe um. Es stellt das Repository vor dem Fix wieder her, prüft, ob sich der historische Patch noch anwenden lässt, führt die Tests vorher und nachher in Docker aus, wiederholt den Lauf nach dem Patch, um Nichtdeterminismus zu erkennen, und verpackt alles mit Prompt, Gold-Patch, Dockerfile, Reward-Skript und Qualitätsurteil.
- Meine Rolle
- Gründer und Entwickler
- Gestartet
- Aktualisiert
- Sichtbarkeit
- Open Source
- isolierte Testläufe vorher und nachher
- Docker
- testbasierter Reward pro Aufgabe
- Binär
- Qualitätsurteile: brauchbar, prüfungsbedürftig, ungültig
- 3
Problem
Benchmarks für Coding-Agenten stützen sich oft auf synthetische Bugs oder auf Aufgaben, die sich nicht zuverlässig prüfen lassen. Das macht die Rewards verrauscht.
Lösung
Eine lokale Pipeline, die eine Aufgabe nur dann als brauchbar markiert, wenn sie reproduzierbar, deterministisch und per Test überprüfbar ist, sodass Erfolg auf ausführbaren Belegen beruht.
Architektur
Eine Reihe kombinierbarer CLI-Stufen (explore, fetch, verify, package, reward) schreibt nachvollziehbare Artefakte auf die Festplatte. Ein Live-Dashboard beobachtet die Pipeline und zeigt Qualitätsschranken und den Bestand an Trainingspaketen.
Was ich gelernt habe
Die meisten historischen Pull Requests ergeben keine guten Trainingsaufgaben. Eine strenge Qualitätsschranke, die Aufgaben als brauchbar, prüfungsbedürftig oder ungültig markiert, hält einen Datensatz vertrauenswürdig.
Technologien
- Python
- Docker
- GitHub API
- Executable rewards
- React dashboard
#coding-agents #reinforcement-learning #evaluation #benchmarks
Weitere Screenshots